 Wolk
ottobre 2026
On device vs cloud: come scegliere per ogni attività AI
Per attività a bassa latenza e dati sensibili scegli l’esecuzione on-device; per ragionamento complesso e contesti lunghi scegli il cloud; nella maggior parte dei casi reali la scelta migliore è un’architettura ibrida. Lo confermano le indicazioni di Google e Apple sui pattern locali e cloud, insieme ai principi dell’EDPB su privacy e minimizzazione. Più avanti trovi la checklist per decidere caso per caso.
In breve:
- Se il volume di richieste è elevato e ricorrente, investire in un modello locale diventa più conveniente rispetto al pagamento a consumo del cloud.
- Per applicazioni con bassa tolleranza alla latenza e forte esigenza di privacy, l’esecuzione on-device elimina i tempi di attesa e garantisce una maggiore sicurezza dei dati.
- La scelta di un’architettura ibrida permette di gestire casi complessi tramite cloud, mantenendo operazioni veloci e sicure direttamente sul dispositivo per funzioni più semplici.
- È fondamentale calcolare i costi totali, inclusi trasferimenti di dati e storage, per verificare il punto di pareggio tra soluzioni locali e cloud prima di implementare.
- La conformità alla privacy richiede di monitorare tutti i passaggi del ciclo di vita dei dati, anche quando l’esecuzione avviene on-device, e chiedere documentazione chiara ai fornitori.
Indice
- Economia e costi: perché l’on-device sta cambiando i conti
- Prestazioni e latenza: come misurare l’impatto sull’utente
- Privacy e conformità: cosa controllare oltre alla sola esecuzione locale
- Capacità dei modelli: trade-off tra dimensione, contesto e qualità
- Vincoli hardware e operativi: cosa considerare per la distribuzione on-device
- Architetture ibride e fallback: pattern pratici e sicurezza
- Checklist pratica per scegliere e testare in produzione
- Considerazioni per sviluppatori: API, runtime e testing
- Caso pratico Wolk: trascrizione on-device e privacy nelle app per agenti immobiliari
- Prospettiva: dove va il mercato e quali segnali monitorare
- Opzione pratica: come Wolk semplifica i sopralluoghi con AI on-device
- Domande frequenti
- Fonti
Economia e costi: perché l’on-device sta cambiando i conti
Il cloud funziona a costo marginale: ogni inferenza ha un prezzo, che cresce linearmente con il volume di richieste. L’on-device inverte la logica: il costo principale è fisso, legato allo sviluppo e alla manutenzione del modello distribuito, mentre l’esecuzione singola non genera spese variabili dirette. AWS descrive bene il vantaggio del cloud per questo tipo di elasticità: scalabilità su richiesta e pagamento a consumo, ideali per carichi variabili o picchi stagionali.
Quando il volume di richieste è alto e ricorrente, però, il conto si ribalta: pagare per ogni singola inferenza diventa più costoso che investire nell’ottimizzazione di un modello locale. Entrano in gioco anche costi indiretti spesso sottovalutati:
- Trasferimento dati e banda, soprattutto con payload ricchi come audio o immagini.
- Storage lato server per log, cache e versioni del modello.
- Picchi di traffico che richiedono capacità extra pagata a tariffa piena.
Per un proof-of-concept, calcola il costo per 1.000 richieste in entrambi gli scenari, il tempo di payback dell’investimento on-device e il punto di pareggio in funzione del volume mensile previsto. Senza questi numeri, qualsiasi scelta resta una scommessa.
Prestazioni e latenza: come misurare l’impatto sull’utente
Il tempo di primo token, o TTFT, misura quanto l’utente aspetta prima di vedere una risposta iniziare a comparire: per interazioni vocali o suggerimenti in tempo reale è spesso più importante della velocità totale di generazione. Google documenta come il runtime LiteRT-LM sia stato progettato proprio per ridurre TTFT e footprint su dispositivi come Chromebook e Pixel Watch.
Google documenta come il runtime LiteRT-LM sia stato progettato per ridurre il tempo di primo token e il footprint del modello su dispositivi come Chromebook e Pixel Watch, un aspetto particolarmente importante per app che richiedono reattività immediata.
L’on-device elimina la latenza di rete e funziona offline, un vantaggio diretto per:
- Trascrizione vocale dal vivo durante un sopralluogo o una visita.
- Suggerimenti in-app che devono apparire mentre l’utente digita o parla.
- Percentili di latenza al 95° e 99° centile, non solo la media, perché sono quelli che un utente percepisce come lentezza.
Se la tua applicazione tollera qualche centinaio di millisecondi di attesa e ha connessione stabile, il cloud resta un’opzione praticabile, come mostrano le potenzialità dell’AI per agenti immobiliari per ottimizzare i flussi di lavoro.
Privacy e conformità: cosa controllare oltre alla sola esecuzione locale
L’EDPB è chiaro: la protezione dei dati va garantita per l’intero ciclo di vita del modello, non solo al momento dell’inferenza. Dichiarare “on-device” non basta: restano obblighi su minimizzazione, conservazione e governance anche quando i dati non lasciano mai il dispositivo.
Prima di considerare un fornitore conforme, verifica questi punti:
- Se raccoglie telemetria o log diagnostici anche in modalità locale.
- Se i dati vengono usati per il training futuro del modello, anche in forma aggregata.
- Se esistono backup automatici che spostano dati fuori dal dispositivo.
- Quanto tempo vengono conservati i dati e chi può accedervi.
Le misure tecniche più solide includono anonimizzazione alla fonte, ambienti di esecuzione affidabili (TEE) e meccanismi di attestation che certificano che il codice eseguito sia quello previsto, senza modifiche indesiderate.
Un consiglio: chiedi sempre al fornitore una descrizione scritta del ciclo di vita dei dati, non solo una dichiarazione di marketing “100% locale”.
Capacità dei modelli: trade-off tra dimensione, contesto e qualità
Un modello in scala device, più piccolo e quantizzato, lavora bene su compiti circoscritti: estrazione di informazioni da un testo, riassunto breve, classificazione di intenti. Apple conferma che il proprio framework Foundation Models è pensato per summarization, estrazione e classificazione, non per conoscenza enciclopedica o ragionamento complesso.
Quando il task richiede ragionamento su più passaggi, generazione di testo lungo e coerente, o chiamate a strumenti esterni (tool-calling), serve un modello in scala server, con finestre di contesto più ampie e capacità di calcolo che nessun dispositivo mobile può replicare.
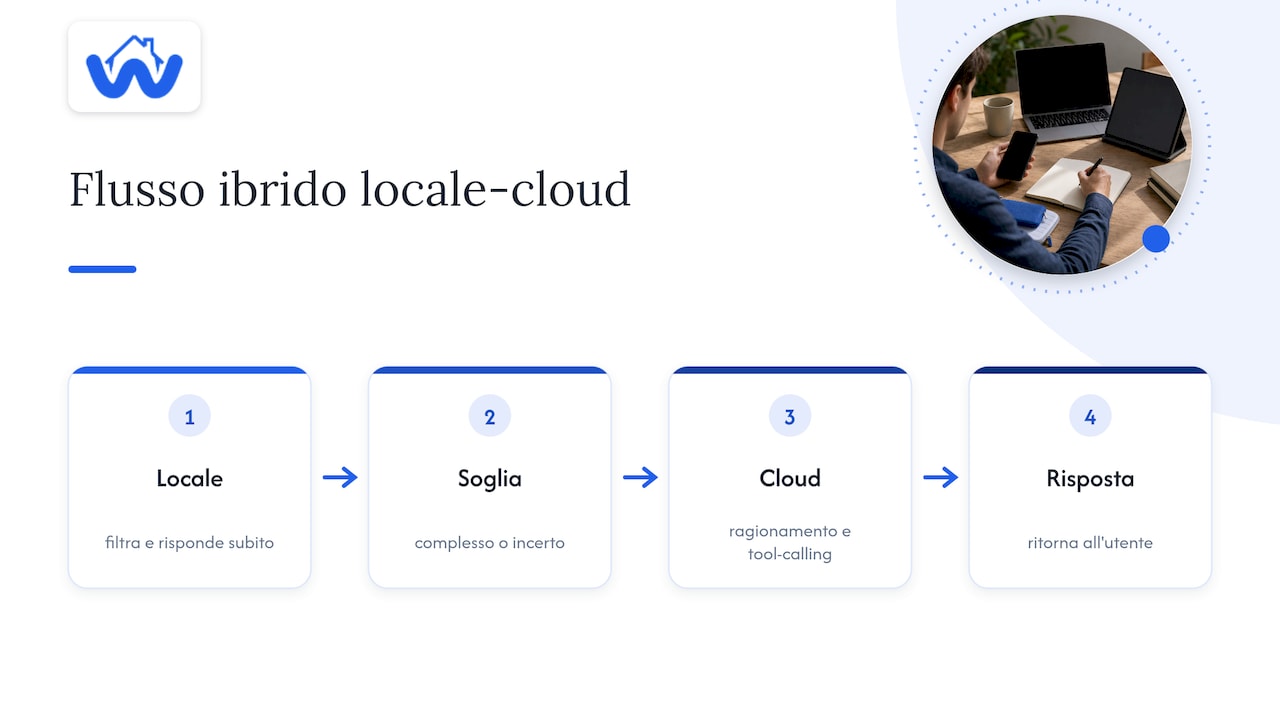
La strategia più efficiente spesso consiste nel dividere il lavoro: il modello locale filtra, classifica e gestisce l’interazione immediata, mentre il cloud interviene solo sui casi che superano una soglia di complessità o incertezza.
Vincoli hardware e operativi: cosa considerare per la distribuzione on-device
Un modello quantizzato per smartphone richiede tipicamente poche centinaia di megabyte di RAM dedicata e spazio di archiviazione proporzionale ai pesi compressi. La disponibilità di una NPU (unità di elaborazione neurale) accelera drasticamente l’inferenza, ma non tutti i dispositivi la offrono con le stesse prestazioni.
L’eterogeneità dei SoC, i system-on-chip che equipaggiano smartphone diversi, obbliga a testare su più modelli di dispositivo prima del rilascio, un costo di ingegneria spesso sottostimato. Vanno considerati anche l’aumento delle dimensioni dell’app per via dei pesi del modello incorporati, la gestione degli aggiornamenti OTA quando il modello cambia versione, e il consumo di batteria durante sessioni di inferenza prolungate.
Architetture ibride e fallback: pattern pratici e sicurezza
Il pattern “piccolo on-device, grande nel cloud” è oggi lo standard più pragmatico. Google lo descrive come una cascata di modelli: il dispositivo gestisce il primo filtro, e solo i casi complessi vengono inviati al cloud. Apple estende questa logica con Private Cloud Compute, un’infrastruttura progettata per non persistere i dati e sottoposta a verifiche indipendenti, utile quando serve un modello con contesto più ampio senza rinunciare del tutto alla fiducia sulla privacy.
Per implementare un fallback affidabile:
- Definisci una soglia di confidenza sotto la quale il dispositivo delega al cloud.
- Misura la lunghezza del contesto richiesto e confrontala con i limiti del modello locale.
- Verifica la disponibilità della rete prima del cutover, con un controllo di availability esplicito.
- Implementa attestation per garantire che l’ambiente cloud remoto rispetti le garanzie dichiarate.
Checklist pratica per scegliere e testare in produzione
Prima di avviare un proof-of-concept, poniti domande concrete: quanto sensibili sono i dati trattati, serve funzionamento offline, quali volumi di richieste attendi, qual è la soglia di latenza accettabile per gli utenti.
Durante il pilota, raccogli:
- Percentili di latenza al 50°, 95° e 99°, non solo la media.
- Costo stimato per 1.000 richieste in entrambi gli scenari.
- Tasso di errore e frequenza dei fallback verso il cloud.
Un piano pilota minimo in sei passi funziona così: definisci il task target, scegli un modello locale e uno cloud equivalente, implementa entrambi su un campione ridotto di utenti, misura costi e latenza per due settimane, confronta i risultati con le soglie di accettazione stabilite in anticipo, decidi se scalare o tornare a un’unica architettura.
Un consiglio: fissa le soglie di accettazione prima di iniziare il pilota, non dopo aver visto i numeri: altrimenti il bias di conferma distorce la decisione.
Considerazioni per sviluppatori: API, runtime e testing
Per chi sviluppa, il primo passo è usare le API di disponibilità per verificare se un dispositivo supporta l’esecuzione locale prima di tentarla, come propone il framework Foundation Models di Apple. Tra i runtime più diffusi per l’on-device, LiteRT-LM di Google e la MediaPipe LLM Inference API offrono strumenti pronti per ottimizzare footprint e tempo di risposta su hardware eterogeneo.
Per il testing, misura sempre il TTFT su più dispositivi reali, non solo in simulazione, e verifica il comportamento di degradazione quando il fallback al cloud fallisce. Un deploy progressivo, con monitoraggio attivo delle metriche su una percentuale limitata di utenti, riduce il rischio di regressioni su larga scala.
Caso pratico Wolk: trascrizione on-device e privacy nelle app per agenti immobiliari
Un esempio concreto di questo approccio riguarda la generazione di annunci immobiliari. Con Wolk, trasformiamo un sopralluogo fotografato e descritto a voce in un kit annuncio completo, pronto per l’MLS, uno script per video social e un messaggio per i clienti, in circa quindici secondi. La trascrizione vocale avviene interamente on-device: nessun dato audio viene caricato su server esterni, un aspetto che tutela la privacy di agenti e clienti durante il sopralluogo.
Quando un fornitore dichiara di lavorare “on-device”, verifica sempre se esiste documentazione tecnica che descrive l’architettura, se la trascrizione avviene realmente senza connessione e se i dati vocali vengono mai inviati altrove per elaborazioni successive. Trovi dettagli sul confronto on-device vs cloud nella trascrizione e sulla dettatura vocale offline per i sopralluoghi.
Prospettiva: dove va il mercato e quali segnali monitorare
I modelli edge diventano più capaci ogni anno, e runtime come LiteRT-LM riducono progressivamente il divario con le prestazioni cloud su compiti circoscritti. Allo stesso tempo, la regolamentazione europea sposta l’attenzione dal “dove” elabori i dati al “come” li governi per tutto il loro ciclo di vita, un punto che l’EDPB ha reso esplicito.
Il consiglio pratico è semplice: misura costi e latenza con regolarità, non una volta sola, e progetta fin dall’inizio un’architettura capace di spostarsi tra locale e cloud senza riscrivere tutto.
— Marco
Opzione pratica: come Wolk semplifica i sopralluoghi con AI on-device
Per agenti e agenzie che vogliono privacy e velocità senza compromessi, disponiamo di piani con limitazioni e opzioni per utenti singoli e team. Esistono soluzioni più articolate per agenzie con esigenze maggiori, con strumenti CRM per la gestione di contatti e trattative.
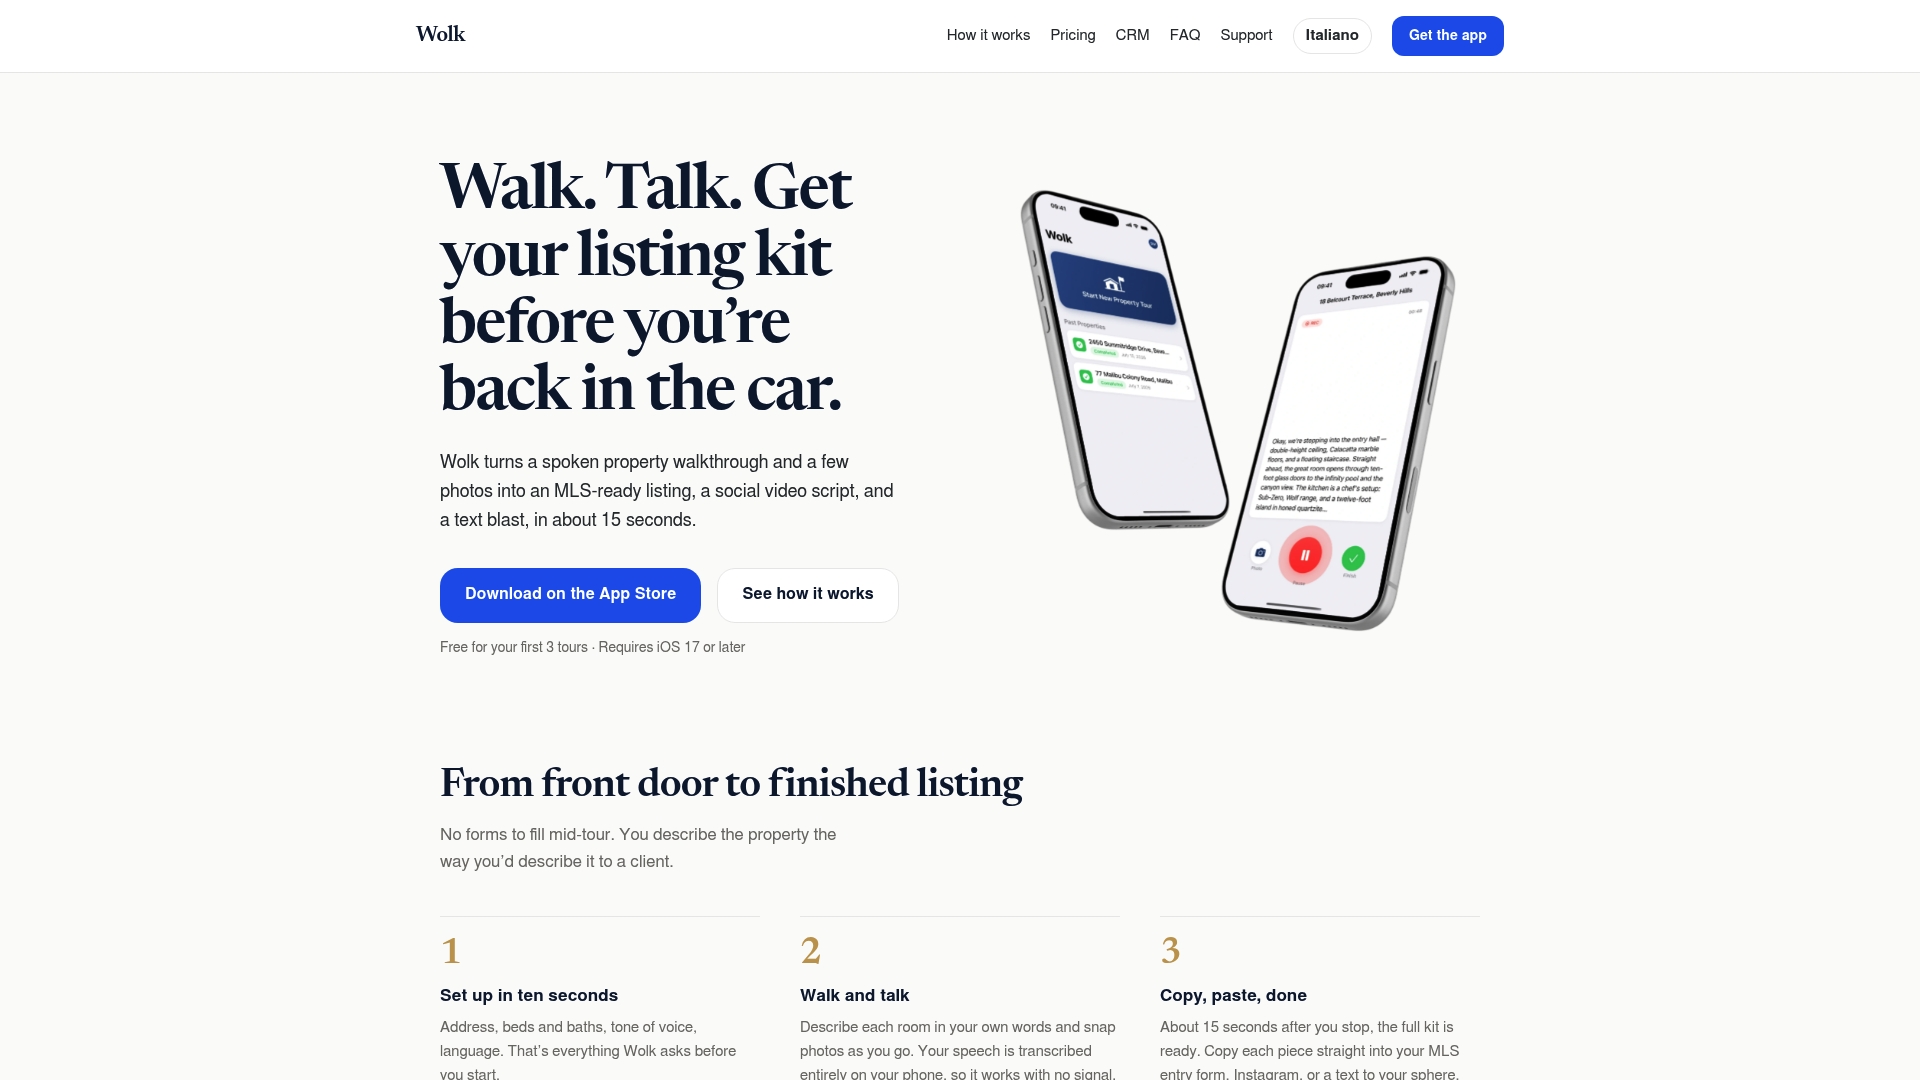
Il cuore dell’offerta è la trascrizione vocale eseguita on-device durante il sopralluogo, che genera rapidamente un kit annuncio e si integra con il flusso di lavoro del team, evitando la compilazione manuale di moduli durante le foto. Se gestisci più immobili al mese, il tempo risparmiato sull’attività amministrativa si traduce rapidamente in più annunci pubblicati. Scopri i piani e inizia su Wolk.
Domande frequenti
Quali sono le differenze principali tra AI cloud e AI on-device?
L’AI cloud elabora i dati su server remoti, offrendo modelli più grandi e contesti più lunghi ma con dipendenza dalla connessione e costo per ogni richiesta. L’AI on-device elabora i dati direttamente sul dispositivo, riducendo la latenza e mantenendo i dati locali, a scapito della capacità di ragionamento su compiti complessi.
Cosa costa di più, una soluzione cloud o on-premise?
Dipende dal volume: il cloud ha un costo marginale che cresce con ogni richiesta, mentre l’on-device o l’on-premise comportano un investimento iniziale più alto ma costi variabili quasi nulli. Per volumi elevati e ricorrenti, l’investimento fisso spesso si ripaga più rapidamente del pagamento a consumo del cloud, come indicano le logiche di pricing elastico di AWS.
L’infrastruttura IT è “nel cloud” o “sul cloud”?
In italiano si parla correttamente di infrastruttura “nel cloud”, intendendo risorse di calcolo e storage ospitate su server remoti gestiti da un fornitore esterno. L’alternativa è l’infrastruttura on-premise o on-device, dove l’elaborazione avviene su hardware locale o sul dispositivo dell’utente.
L’intelligenza artificiale di Apple funziona tutta sul dispositivo?
No: Apple combina elaborazione on-device per compiti come summarization e classificazione con Private Cloud Compute per richieste che necessitano di modelli più ampi, come spiegato nelle sessioni Apple su Foundation Models. Private Cloud Compute è progettato per non persistere i dati inviati e per sottoporsi a verifiche indipendenti.
Come decido se Wolk è adatto al mio flusso di lavoro immobiliare?
Se cerchi uno strumento che generi annunci e script social a partire da un sopralluogo vocale senza caricare l’audio su server esterni, la trascrizione on-device di Wolk risponde a questa esigenza specifica. Il piano gratuito con tre tour permette di verificare il flusso prima di passare a un abbonamento Pro o Growth.
Fonti
- Enabling more private generative AI - Google Developers Blog
- Build with the new Apple Foundation Model on Private Cloud Compute - WWDC26
- Opinion 28/2024 on certain data protection aspects related to the processing of personal data in the context of AI models
- What is cloud computing? - AWS